从每个字节中释放更多性能:全栈协同设计如何解决 AI 的内存挑战
随着模型规模不断扩大、上下文窗口越来越长,再加上智能体应用的兴起,GPU 内存压力正不断增加;与此同时,供应趋紧、价格上涨,这一趋势在短期内预计仍将持续。 NVIDIA 与内存生态伙伴密切合作,推动最新内存技术快速应用。NVIDIA 率先将 HBM3e 和 HBM4 技术应用于加速计算堆栈中。 但解决思路并非简单地在 GPU 上堆叠更多内存,而是采用全栈协同设计。NVIDIA 将 GPU、CPU、网络、存储和软件统一设计,从而在 AI 工厂的每一层都让内存产出更多有效工作量。 这一点至关重要,因
随着模型规模不断扩大、上下文窗口越来越长,再加上智能体应用的兴起,GPU 内存压力正不断增加;与此同时,供应趋紧、价格上涨,这一趋势在短期内预计仍将持续。
NVIDIA 与内存生态伙伴密切合作,推动最新内存技术快速应用。NVIDIA 率先将 HBM3e 和 HBM4 技术应用于加速计算堆栈中。
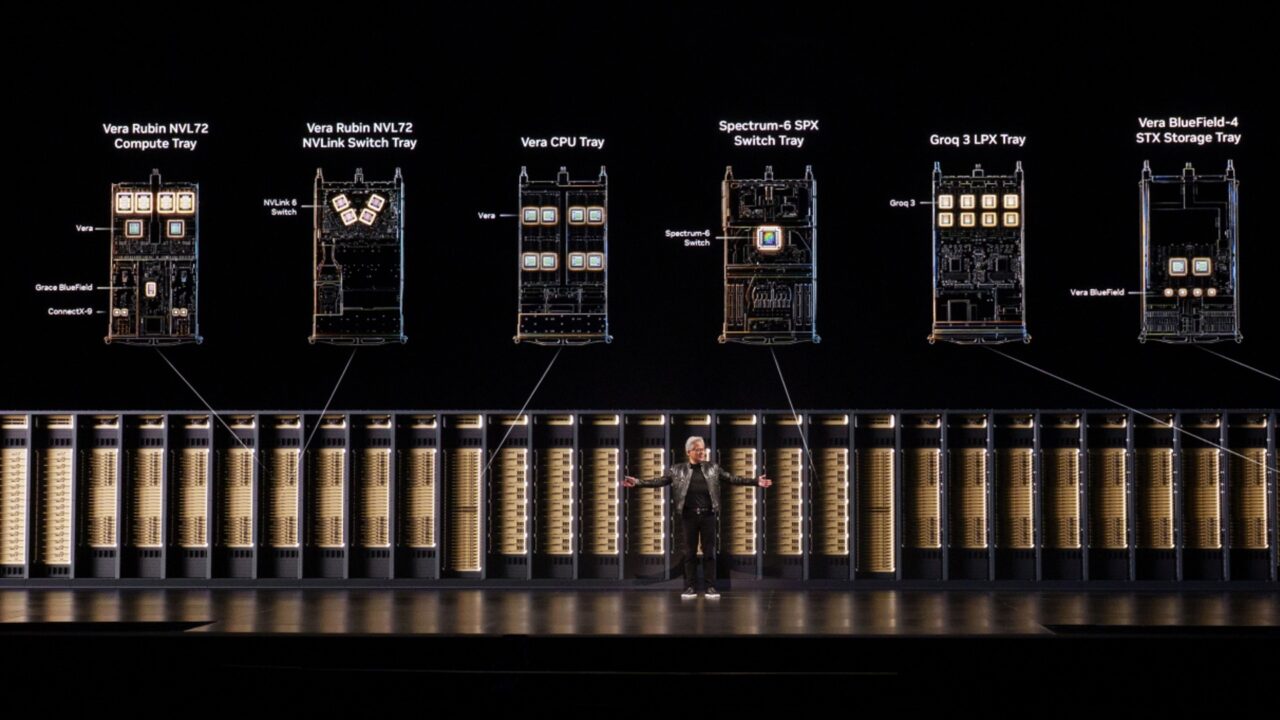
但解决思路并非简单地在 GPU 上堆叠更多内存,而是采用全栈协同设计。NVIDIA 将 GPU、CPU、网络、存储和软件统一设计,从而在 AI 工厂的每一层都让内存产出更多有效工作量。
这一点至关重要,因为 AI 工厂的运行在内存与存储层级架构之上。GPU 高带宽内存 (HBM) 是速度最快、成本最高、也是争夺最激烈的层级 —— 模型权重和 KV 缓存都在争夺其有限的容量。在其之下则是 CPU 内存、本地 SSD 和共享存储,每一层都以速度换取了更大的容量,从而实现了更低的单位比特成本。
一个字节能产生多少有效工作量,取决于整个层级架构的利用效率:包括压缩必须存储的数据量、将其放置在合适的层级,并在需要之前及时将其调回 GPU。
逐字节来看,NVIDIA 在每一层都实现了最高效的内存利用 —— 实际表现也印证了这一点。从 NVIDIA Blackwell Ultra 到 Vera Rubin 平台,单个 GPU 的 HBM 容量仅提升了约 3%,而在 SemiAnalysis AgentX 基准测试中,每美元智能体吞吐量最高提升了 30 倍。
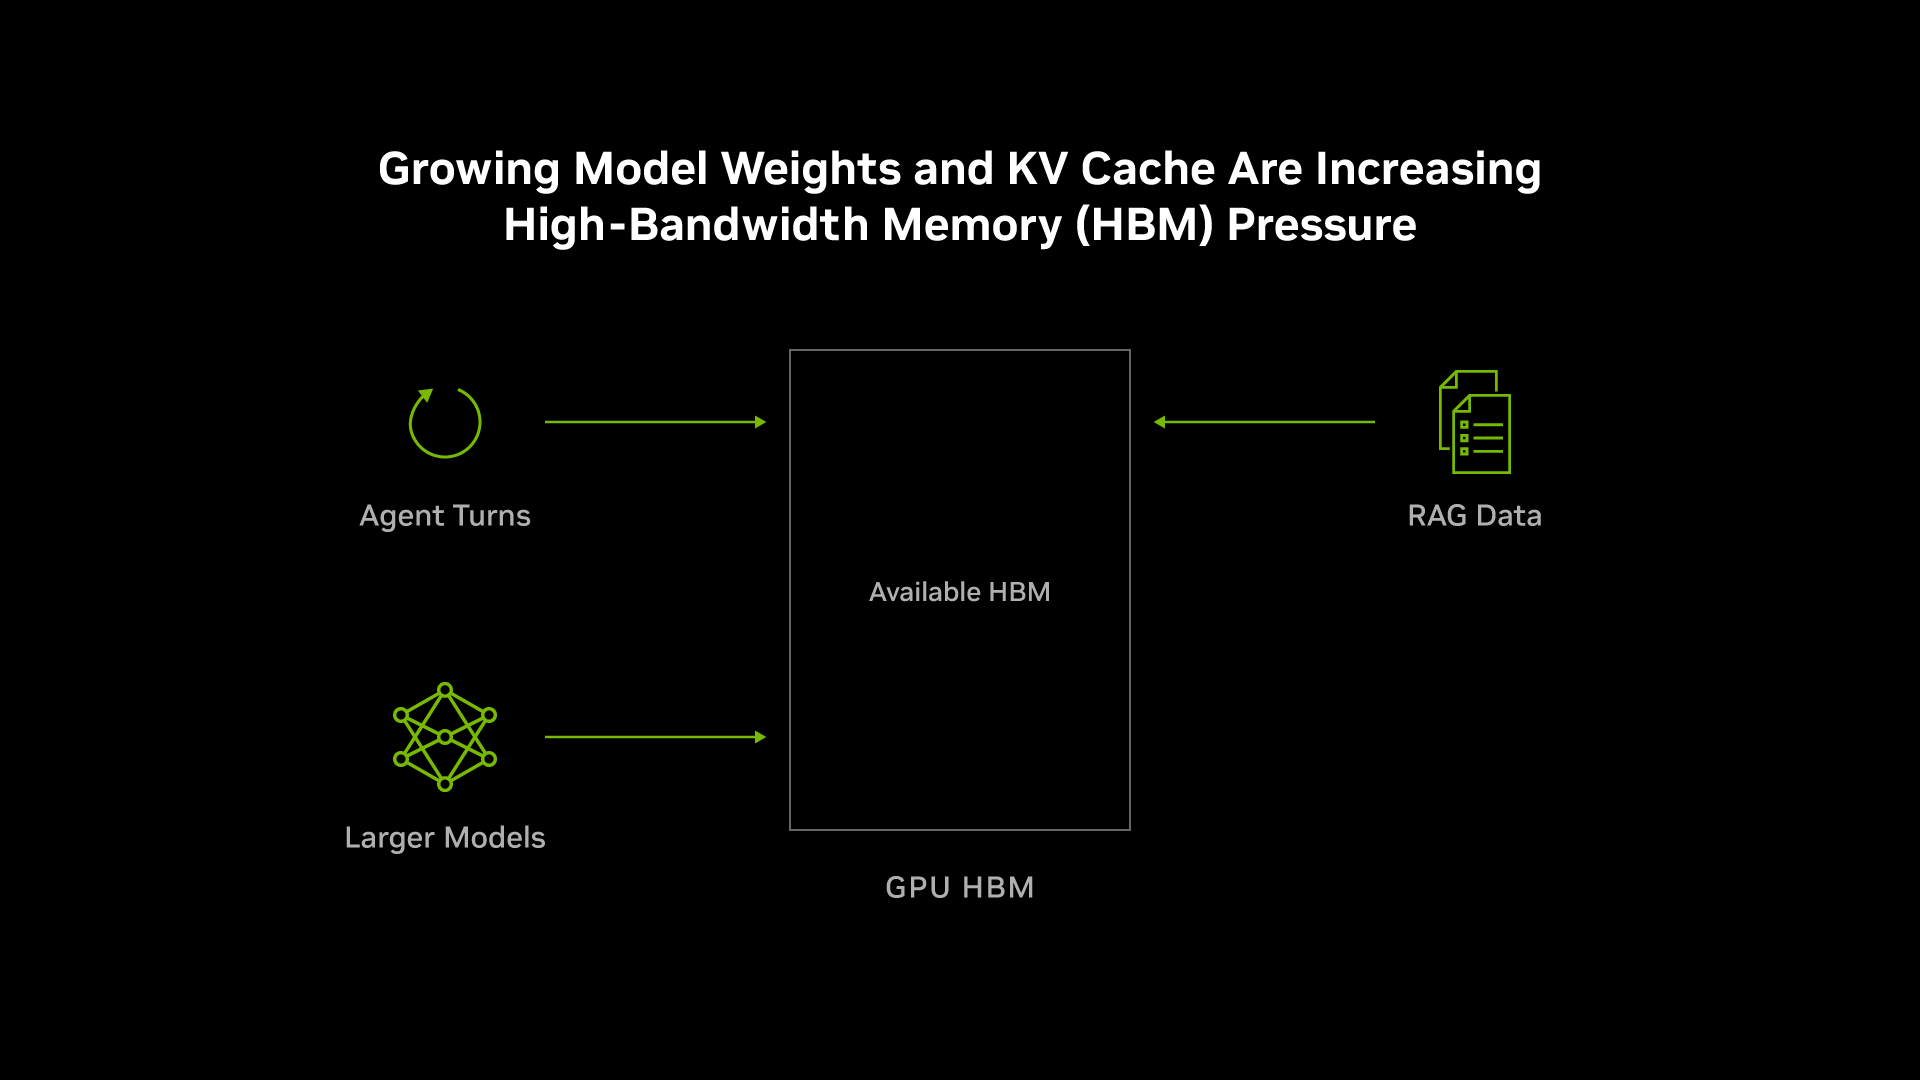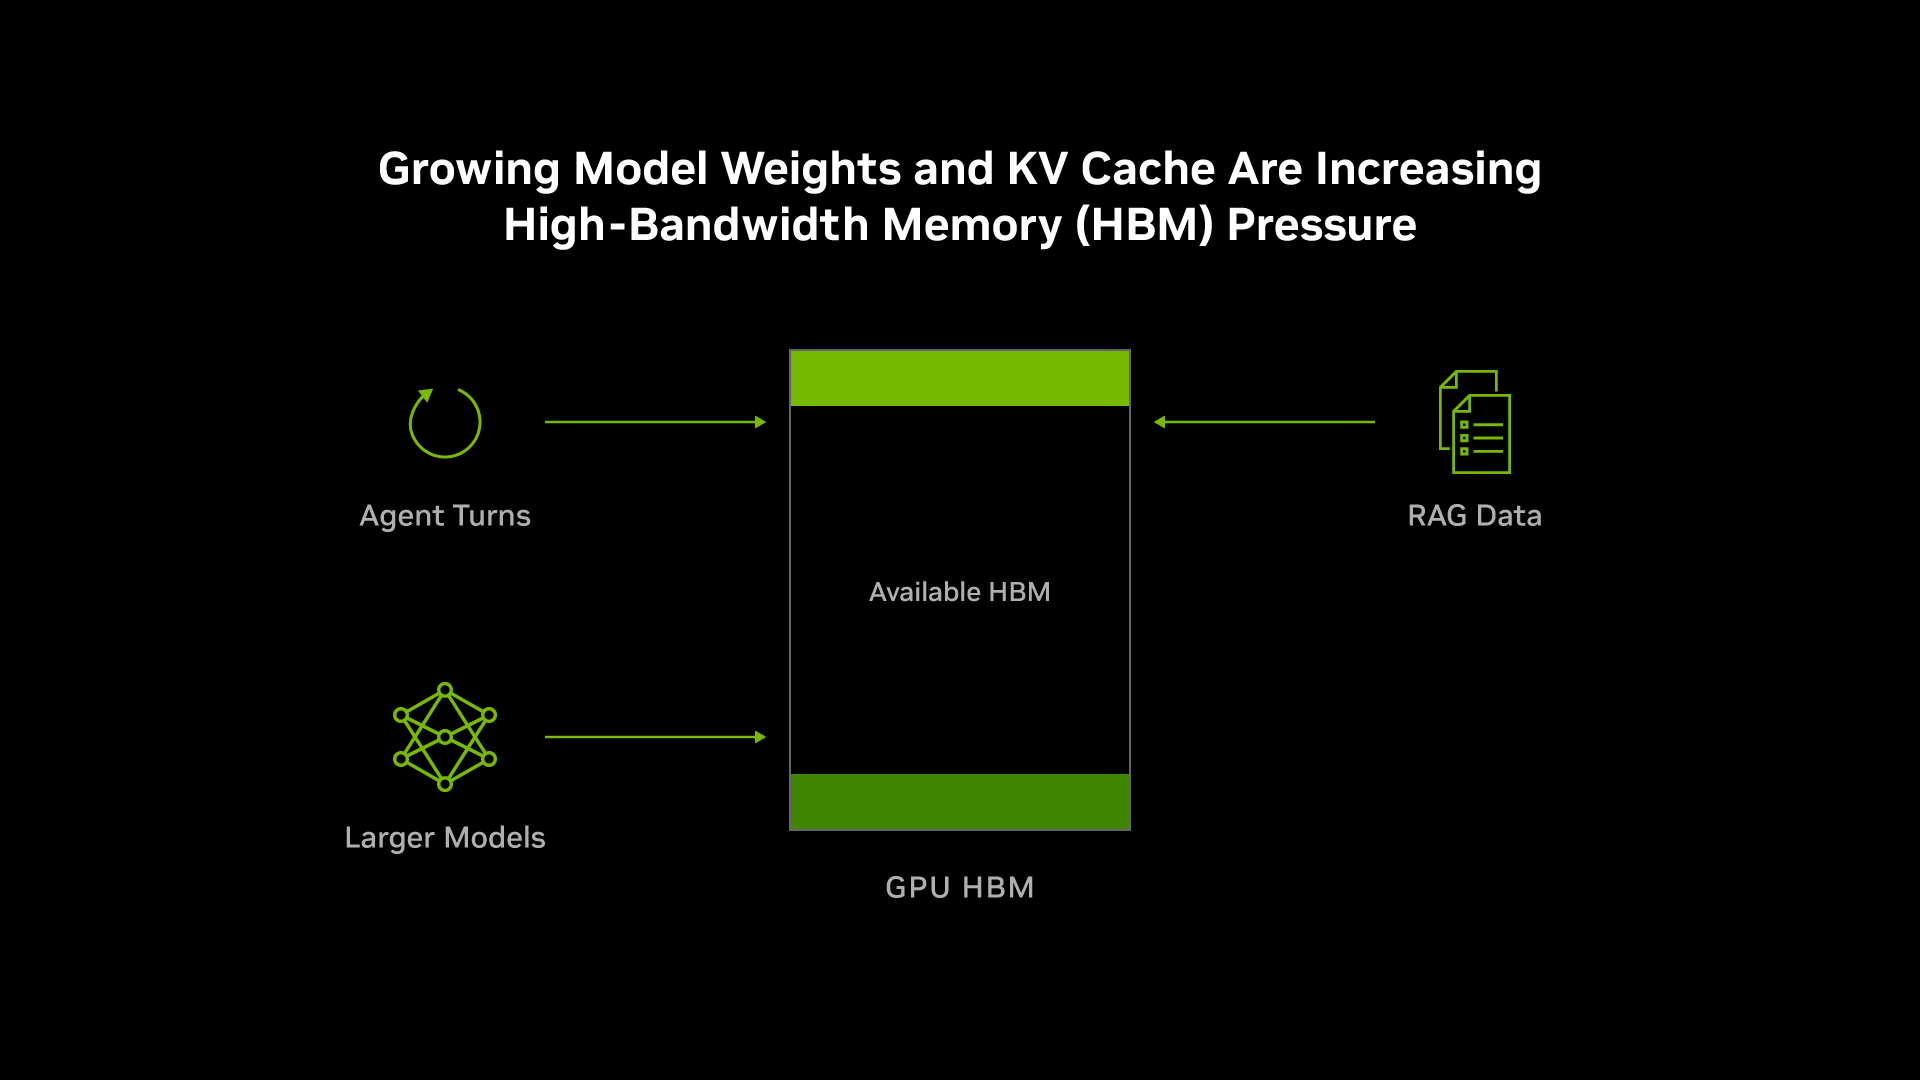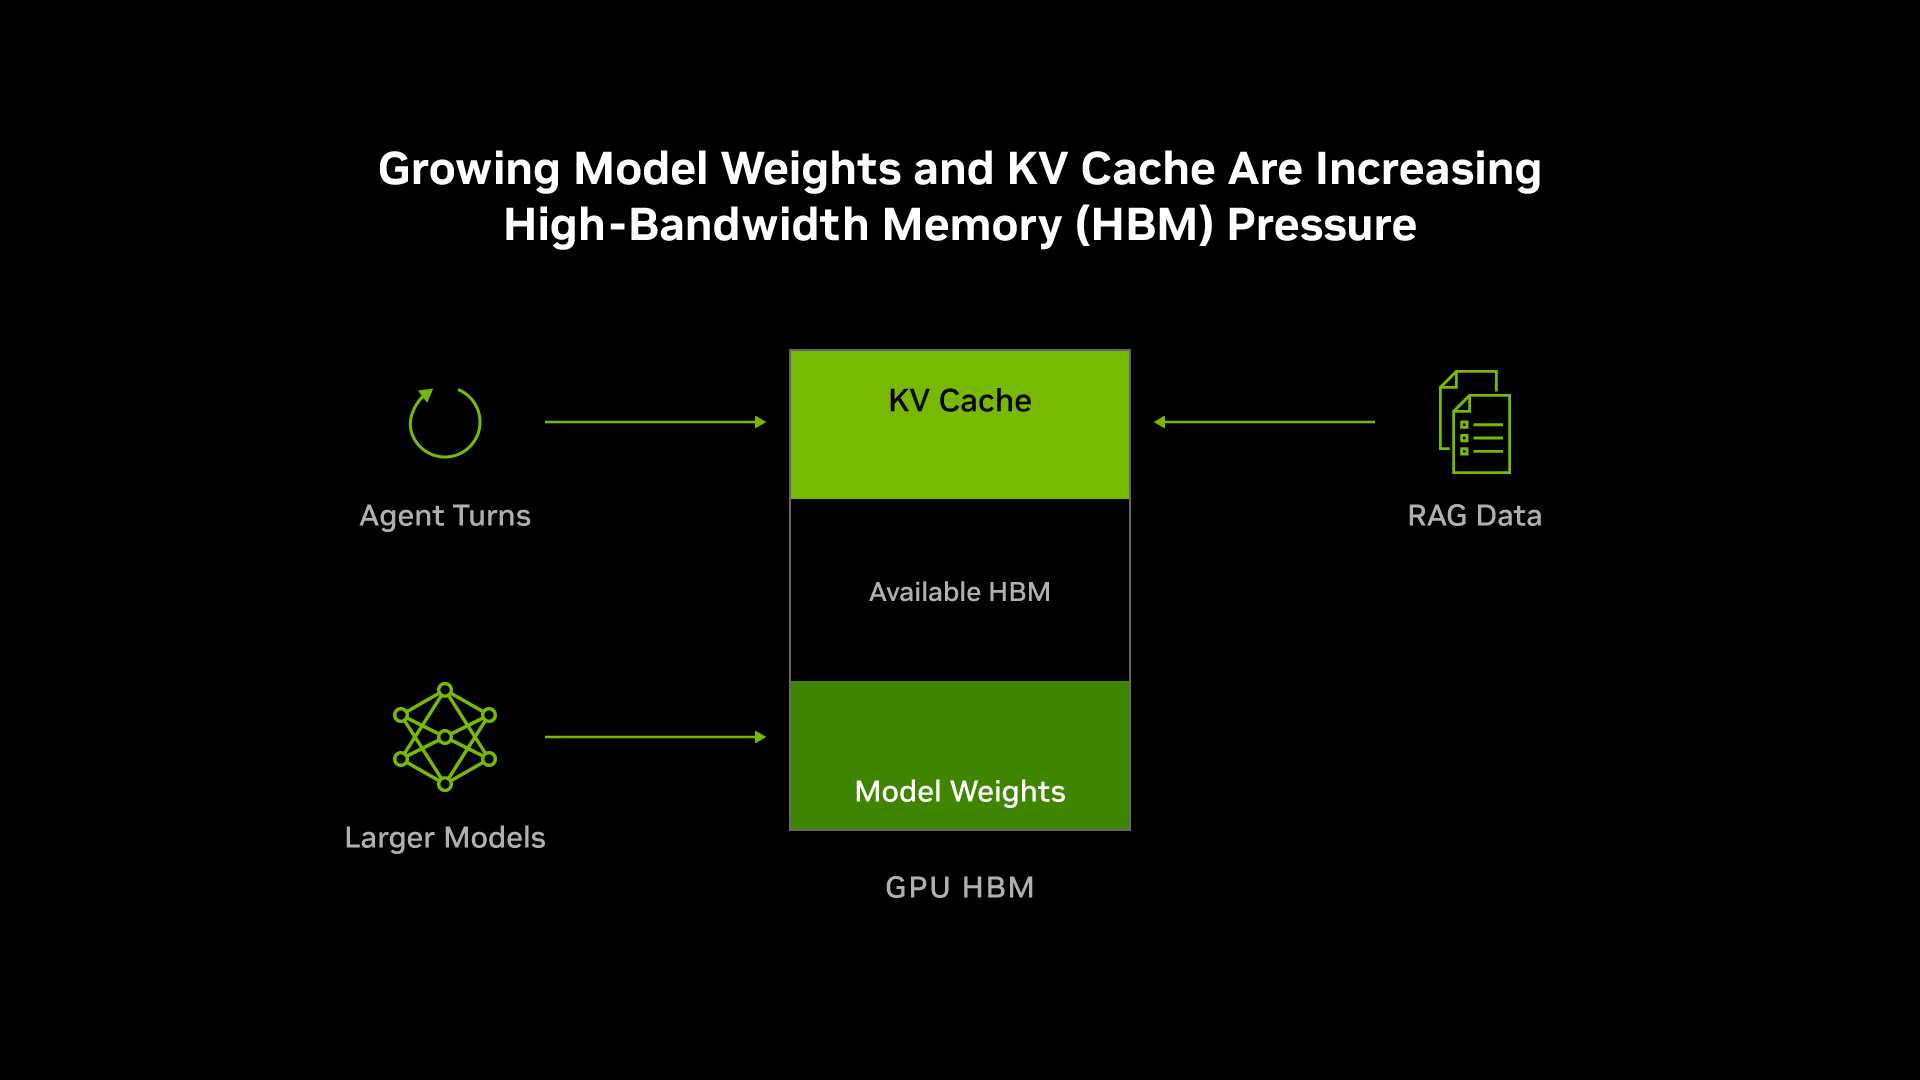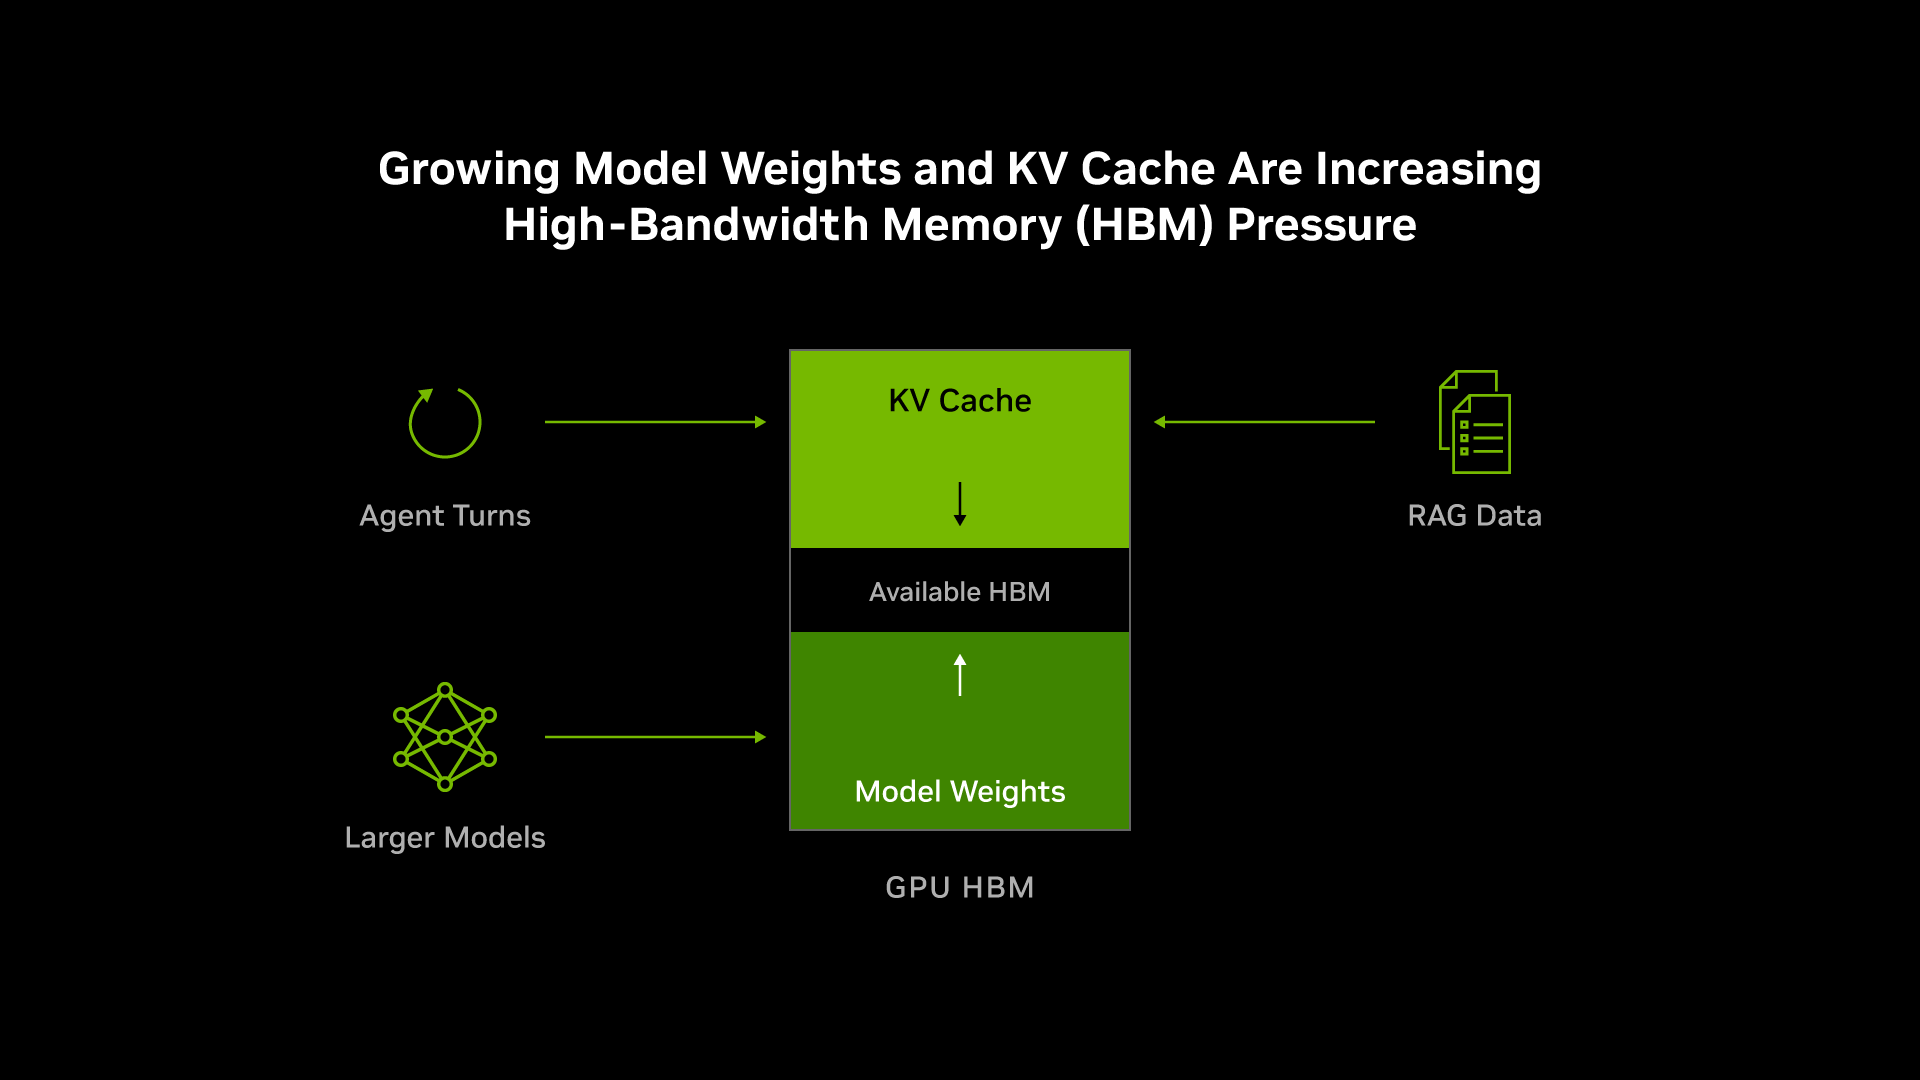
智能体推理正给 HBM 带来更大压力
前沿模型如今已拥有万亿级参数 —— 这些参数承载着 AI 模型在训练阶段学习并存储知识的数值。
KV 缓存也在不断膨胀 —— 它保存着模型理解当前每个活跃请求所需的上下文,从而避免重复处理相同信息。智能体执行轨迹会在多次模型调用和工具调用之间持续携带历史上下文,在某些场景下需要处理多达 300 万个 Token,因此每个请求的工作内存会随时间不断增长。
检索增强生成 (RAG)会在提示词中补充相关的企业信息,从而产生更多需要处理和保留的上下文。
在推理过程中,HBM 主要承载着模型参数和 KV 缓存。其结果便是:HBM 面临着更大的压力。
为什么 AI 工厂需要内存层级架构
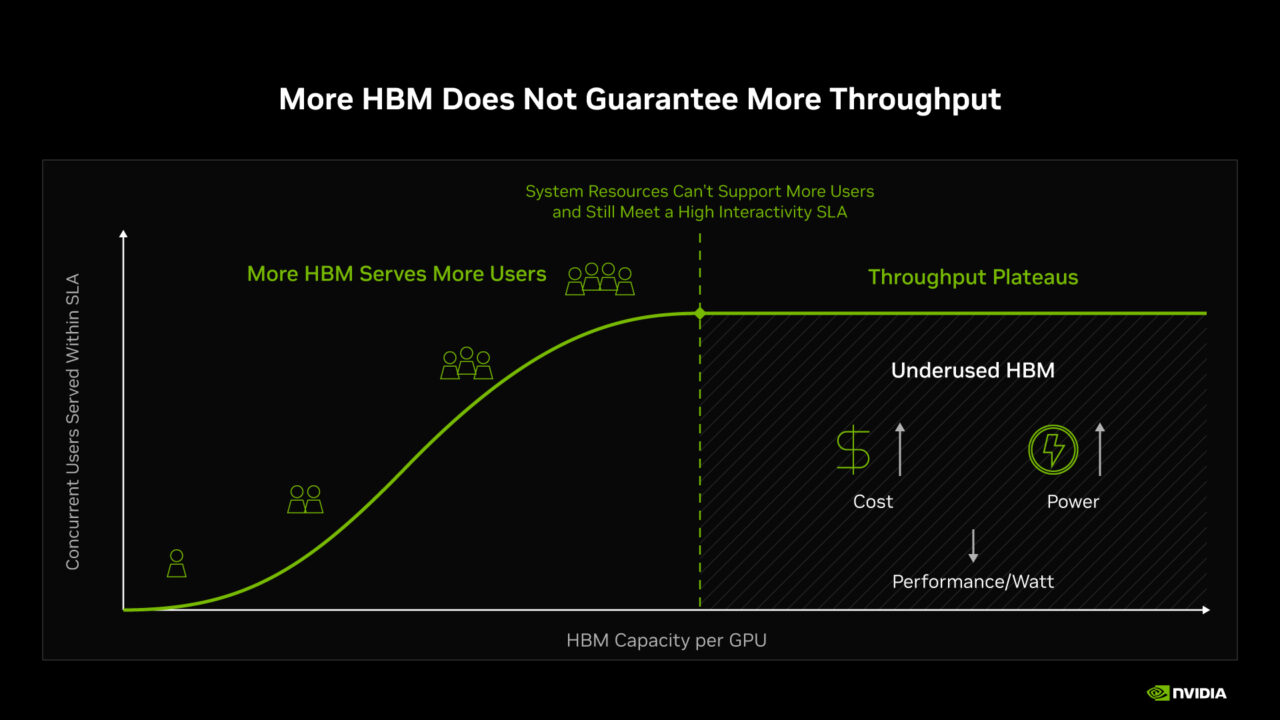
增加单个 GPU 的 HBM 容量看似是应对这一压力的直接方案,但容量所能发挥的作用,始终受限于带宽的传输能力。
不妨将 HBM 视作一座仓库,而内存带宽则是它的装卸码头。更大的仓库能存放更多库存,但码头决定了每次能进出多少货物。一旦码头达到饱和,搬运更多库存就需要更长的时间,进而拖慢响应速度。如果延迟超出了服务等级要求,那么新增的存储空间不仅无法被有效利用,反而会增加成本并消耗更多电力。
这也正是为什么没有任何系统会将全部库存都存放在距离最近、速度最快的空间中。正在流转的数据留在靠近“产线”的位置,而处于等待状态的数据则被移至附近更大、更经济的存储空间,并在被需要之前及时调回。
AI 工厂也面临着同样的限制。
增加 HBM 确实能容纳更多 KV 缓存,并支撑更多并发用户。但每新增一个用户,都会共享相同的算力和内存带宽。而当每个用户都要求快速响应时,内存带宽最终将无法以计算所需的速度来供给数据 —— 工程师们将这一瓶颈称为“内存墙”。
越过这一临界点后,新增的 HBM 容量无法被有效利用,却仍会带来额外的成本并消耗更多电力。数据固然需要存储空间,但并非所有数据都需要存放在速度最快、成本最高的层级。这正是 AI 工厂需要在内存与存储层级体系中统筹管理数据的原因。
通过全栈协同设计,最大化每一字节的价值
NVIDIA 的全栈协同设计通过缓解模型权重、KV 缓存和 RAG 数据带来的压力,让 HBM 中的每一字节都物尽其用。其实现方式采用了多项技术,各自针对不同的资源效率瓶颈:
压缩模型权重,并将其分布部署在 NVL72 域内。
- 与 NVIDIA Hopper 平台上可用的最低精度 FP8 相比,NVFP4 格式进一步降低了权重所需的空间。近期发布的多个模型均提供了 NVFP4 检查点,包括 Black Forest Labs 的 FLUX.2 [klein]、Thinking Machines Lab 的 Inkling、Reflection 的 Beam 1.0、Meta 的 Meta Muse Spark、阶跃星辰的 Step 5 Preview 以及 NVIDIA Nemotron 3.5 Super VL。体现出模型开发者对 4 位精度的采用正日益广泛,以实现更快、更节省内存的推理。
- 在 NVL72 系统中,模型权重可分散部署在多达 72 个 GPU 上,使每颗 GPU 只需承载模型的一小部分,从而为 KV 缓存和并发用户留出更多 HBM 空间。
压缩 KV 缓存,并将非活跃上下文卸载至更低成本的存储层级。
- 将 NVFP4 应用于 KV 缓存,其存储占用相比 FP8 进一步降低,从而使更多上下文能够驻留在 HBM 中。
- NVIDIA Vera CPU 从两方面提供支持:更快的工具执行速度缩短了 KV 缓存在工具调用期间的闲置时间;其大容量 LPDDR 内存通过 NVIDIA NVLink-C2C 互连技术与 NVIDIA Rubin GPU 相连,为暂停的上下文提供了一个就近暂存并快速返回的位置。
- 当上下文处于非活跃状态时,NVIDIA Dynamo 推理软件会将其迁移至 NVIDIA CMX 上下文记忆存储 —— 这一存储层级专为大容量设计,每比特成本远低于 HBM —— 并可在复用前将其调回。与本地 SSD 不同,CMX 可在多台服务器之间共享;与传统企业级存储不同,CMX 无需承担短期上下文数据并不需要的长期数据保护开销。NVIDIA CMX 上下文记忆存储的合作伙伴包括 Cloudian、DDN、戴尔科技、Everpure(原 Pure Storage)、HPE、IBM、NetApp、VAST 和 WEKA。
- Dynamo 的 KV 缓存复用 (KV Cache Reuse) 将各存储层级连接起来,把 GPU 内存、CPU 内存和存储中的 KV 缓存作为统一的系统级资源进行管理,使一次计算生成的上下文能够在整个系统内复用。
压缩 RAG 嵌入向量,并将索引放在 HBM 之外。
- RAG 将企业文档转化为嵌入向量 —— 一种让系统能够按语义而非关键词进行搜索的数值表示 —— 并将其组织成可检索的索引。NVIDIA Nemotron Retriever 模型能够生成更紧凑的嵌入向量,同时实现更高的检索准确率;而 NVIDIA cuVS 库则支持在 CPU 和存储层构建并提供索引服务。知识库本身不会占用 HBM,只有模型实际需要的文本片段才会进入上下文。
最终结果是,模型权重与闲置上下文占用的 HBM 更少,而可用于服务并发用户的 HBM 则更多。
每一代产品都带来更高的每美元有效产出
在 NVIDIA 各代平台演进中,每美元每秒 Token 数的增长速度远高于 HBM 容量的增长。
在 SemiAnalysis AgentX 的 DeepSeek V4 Pro 工作负载测试中,在每位用户每秒生成 100 个 Token 的交互速度下,NVIDIA Grace Blackwell Ultra 系统的每美元吞吐量最高可达 NVIDIA Hopper 平台的 10 倍,而单个 GPU 的 HBM 容量则提升至约 2 倍。在每位用户每秒 125 个 Token 的交互速度下,Vera Rubin 系统的每美元吞吐量最高可达 Grace Blackwell Ultra 系统的 30 倍,而单个 GPU 的 HBM 容量仅增加约 3%。
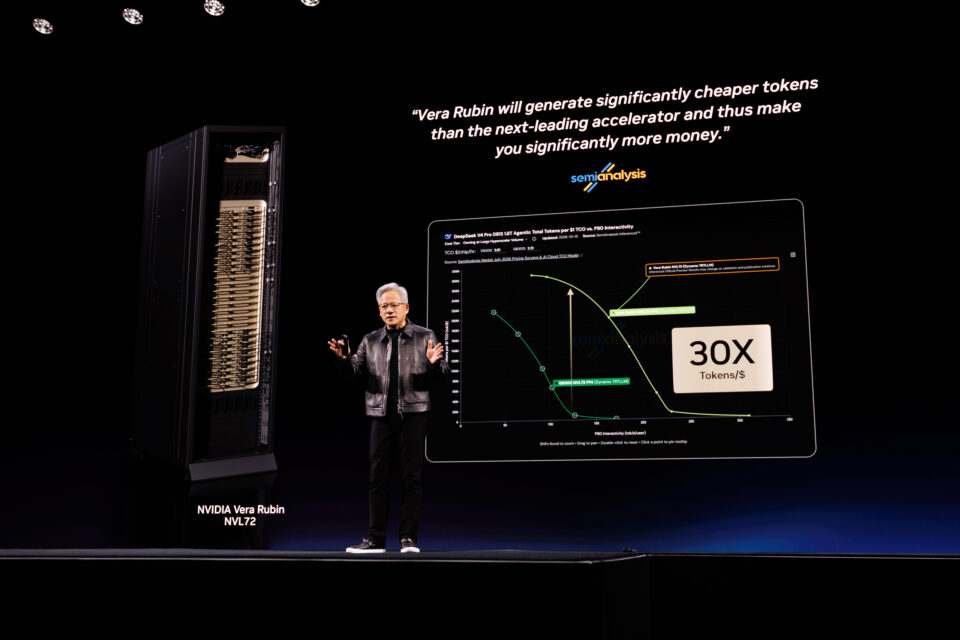
对于 AI 工厂运营者而言,关键指标在于工厂如何在满足用户响应时间要求的同时,在既定功耗预算内交付尽可能多的有效 Token。每瓦特每秒生成的 Token 越多,意味着在同等电力条件下可完成更多工作、创造更多收益,并降低每 Token 成本。NVIDIA 的全栈协同设计通过提升每字节内存所能产出的有效工作量,从而降低 Token 成本。