

NVIDIA DGX Spark 64GB 为开发者提供更多方式构建和扩展本地 AI
本地 AI 正以 Token 为单位,变得更加实用。 AI 智能体从实验阶段走向日常开发,能力日益增强的开放模型正变得更轻量,能适配更多设备,让开发者可以在本地运行更多 AI 工作负载。 本月,NVIDIA DGX Spark 将推出配备 64GB 统一内存的新配置,由宏碁、华硕、戴尔、技嘉、惠普和微星等顶级 OEM 合作伙伴提供,该配置预装 DGX OS 和 NVIDIA AI 软件栈,开箱即用,为开发者、研究人员和 AI 爱好者带来全新规格产品。 这款全新规格产品可在设备端运行强大的本地智能
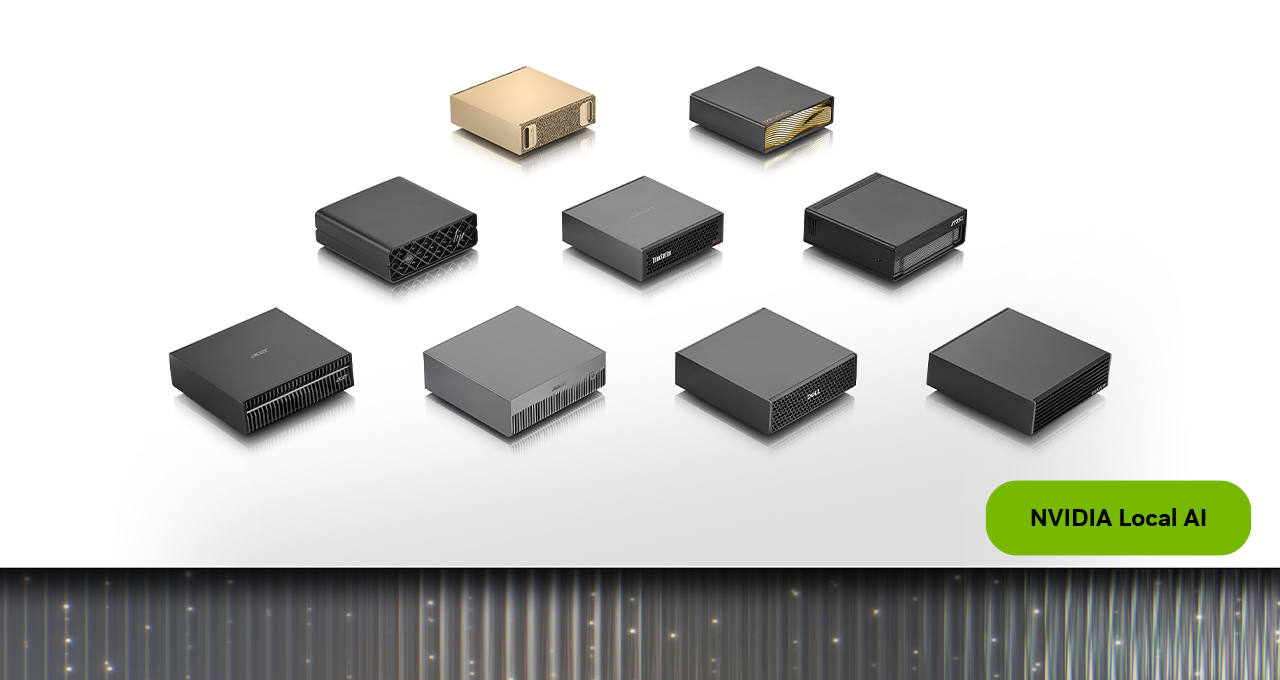
本地 AI 正以 Token 为单位,变得更加实用。
AI 智能体从实验阶段走向日常开发,能力日益增强的开放模型正变得更轻量,能适配更多设备,让开发者可以在本地运行更多 AI 工作负载。
本月,NVIDIA DGX Spark 将推出配备 64GB 统一内存的新配置,由宏碁、华硕、戴尔、技嘉、惠普和微星等顶级 OEM 合作伙伴提供,该配置预装 DGX OS 和 NVIDIA AI 软件栈,开箱即用,为开发者、研究人员和 AI 爱好者带来全新规格产品。
这款全新规格产品可在设备端运行强大的本地智能体——保护隐私,无需依赖云端。当工作负载增加时,两台设备可通过 NVIDIA Sync Cluster Assistant 组成集群,无需额外设置。
个人 AI 超级计算的全新起点
DGX Spark 将 NVIDIA Grace Blackwell 计算能力、统一内存、NVIDIA ConnectX-7 网络以及 NVIDIA CUDA 加速的 AI 软件栈集成于一个系统之中。它是一套完整的本地 AI 平台,适用于运行智能体、推理、微调、数据科学和边缘开发。
这款紧凑型的个人 AI 超级计算机让开发者使用模型和自身数据进行实验,无需每项任务都依赖云端实例。
全新 64GB 统一内存配置仅通过 OEM合作伙伴提供,在保持更易于接受的价格定位的同时, 搭载与 128GB 型号相同的 GB10 Grace Blackwell 超级芯片、DGX OS 及完整 NVIDIA AI 软件栈。它支持在设备本地完整运行最高 1,000 亿参数的模型,以及基于这些模型构建的智能体应用。
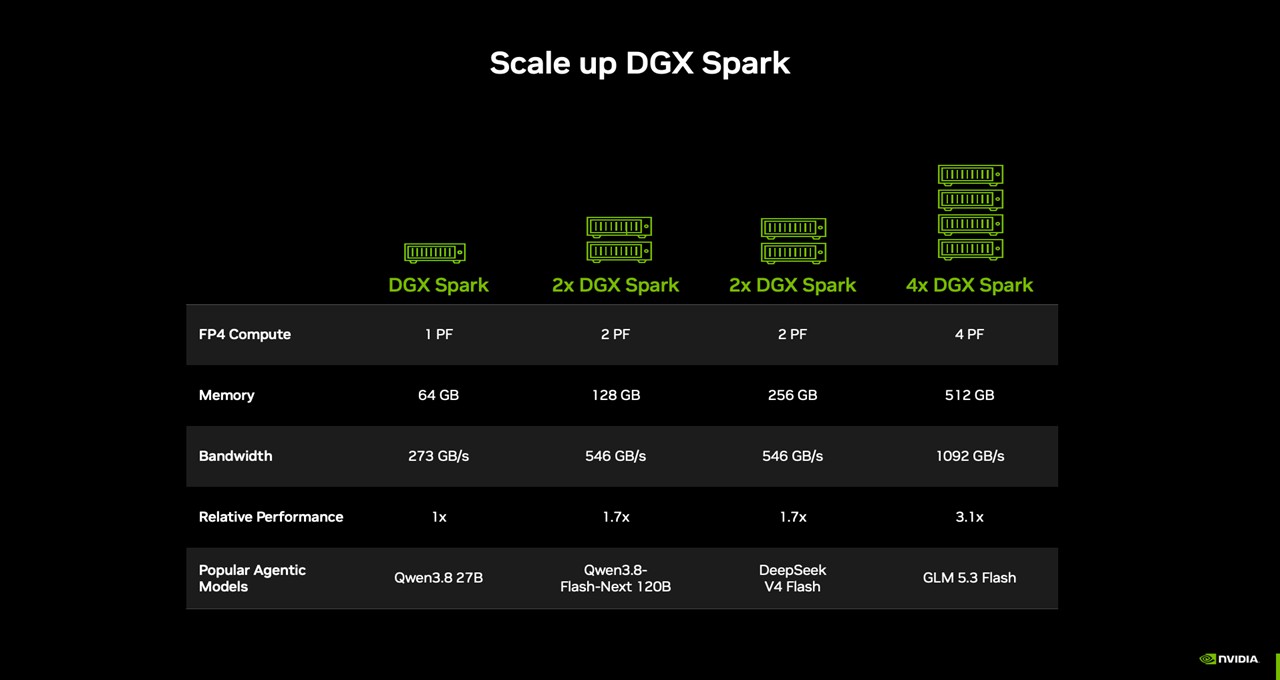
两台 64GB 设备组成集群后,带来的不只是内存翻倍。在 NVIDIA 对 Qwen 3.8 27B 的测试中,两台组成集群的 64GB 系统相比单台 128GB 系统,性能提升最高可达1.7倍;而且还能随着工作负载需求的增长继续扩展。
DGX Spark 从开箱第一天起便可用于 AI 智能体开发—— 开箱即支持 NVIDIA Agent Toolkit、CUDA‑X AI 库、Nemotron 开放模型,以及 Ollama、vLLM 和搭配 CUDA 的 PyTorch 等常用运行时。
开发者只需几分钟,即可从开机完成到模型运行。
Blender 是首批支持该平台的主要创意应用提供商之一,即将推出预构建的可下载安装程序。
使用 NVIDIA Sync Cluster Assistant 实现规模
开发者可以从项目当前所需的内存容量起步,并基于这一平台,随着工作流不断发展,无缝扩展为多节点集群,以应对更大规模的工作负载。
每台 DGX Spark 均开箱内置 NVIDIA ConnectX-7 网卡。此外,两台设备可通过 QSFP 线缆直接连接,将内存汇集并提升至 128GB,把模型支持扩展至最高 2,000 亿参数,同时带来两倍的内存带宽和最高 1.7 倍的性能提升。
NVIDIA Sync 应用可无缝配置这一多节点集群配置。Cluster Assistant 功能会检测已连接的设备、验证设备配置,并配置 ConnectX-7 网络,让开发者能专注于自身工作,而无需操心基础设施。每个节点都运行相同的 NVIDIA 软件栈,因此从一台设备扩展到两台时,无需重新配置任何内容。
NVIDIA Sync Model Launcher 而将于本月底推出的,让运行本地 AI 变得像点击几个按钮一样简单。开发者可以在单台 DGX Spark 系统或集群上下载并启动 Qwen3.8 27B,NVIDIA Sync 会自动将模型配置为跨已连接设备运行,并让用户可以从笔记本电脑访问该模型。 启动器还会设置 OpenCode 以使用该模型,让开发者可直接在浏览器中开始编程。
DGX Spark 上的开发者用例
全新 DGX Spark 64GB 配置从第一天起即可支持实际开发工作。借助可完全在设备本地运行的、最高 1,000 亿参数模型,开发者和爱好者可以先使用单台系统运行能够容纳于其内存中的模型;也可通过 NVIDIA Sync Cluster Assistant 连接多台 DGX Spark 系统,应对需要更多内存和算力的负载。
以下是三个工作流示例:
- 全天候运行 AI 智能体:让编程或研究型AI智能体持续运行在 DGX Spark 上,随时审查代码、分析文档或执行多步骤任务。集群可为更大模型、更长上下文窗口或多个智能体同时运行提供额外容量。
- 为日常 PC 提供 AI 应用加速:在笔记本电脑或台式机上使用智能体或创意应用的同时,在 DGX Spark 上运行语言或图像生成模型。DGX Spark 负责模型推理,从而释放 PC 资源以处理其他工作。
- 工作增长时扩展:当单个任务超出单台设备的承载能力——例如运行更大的模型、更长的上下文窗口或处理并发的智能体请求——可通过 NVIDIA Sync Cluster Assistant,将两台 DGX Spark 64GB 系统经由 200GbE 网络连接,并将内存资源整合至 128GB。此前在单台设备上运行的同一工作流可扩展至两台,无需重新配置软件环境。
开始使用 DGX Spark
DGX Spark 64GB 将于 10 月 23 日通过 宏碁、华硕、戴尔、技嘉、惠普和微星发售,建议零售价 4,999 美元起。
开始使用:
- 下载受支持的推理框架——llama.cpp、Ollama、vLLM 或 LM Studio。
- 下载适用于该工作流的推荐本地模型。
- 要扩展至两台设备,请通过其 NVIDIA ConnectX-7 端口连接,并启动 NVIDIA Sync Cluster Assistant——它会自动配置网络并路由负载。
如需了解 DGX Spark 上的代理式 AI 实战指南,请访问 https://developer.nvidia.cn/build-spark 上的 NemoClaw、OpenClaw、Hermes Agent 和 OpenShell 页面。
#别错过:NVIDIA 本地 AI 的更多最新动态
欢迎在 https://developer.nvidia.cn/build-spark 上探索面向 DGX Spark 的实战指南。以下实战指南即将登陆 64GB 设备:
- 使用 vLLM 部署大语言模型 (LLM)
- 使用本地 LLM 运行 OpenClaw
- 连接多台 DGX Spark 以应对分布式负载
搭载 NVIDIA RTX Spark 的全新 Windows 电脑 将于本月由 宏碁、华硕、戴尔、惠普、联想、微软和微星推出。订阅 RTX Spark 新闻,即可获取未来最新动态。
阿里巴巴的 Qwen-Image-2.1 将图像生成与编辑功能集于一身,采用轻量级开放权重模型。它可在 NVIDIA RTX GPU、DGX Spark 上本地运行,为创作者提供更多在自己的硬件上创建和完善图像的方式。
NVIDIA RTX AI PC的相关信息请关注微博、抖音及哔哩哔哩官方账号,并订阅 NVIDIA 本地 AI 新闻通讯,及时了解最新动态。有关 NVIDIA 工作站的更多信息,请关注微信公众号。
软件产品信息请查看声明。