
高效、耐用、可互换:NVIDIA AI 工厂如何实现投资回报最大化
AI 工厂的建设规模以兆瓦甚至达到十亿瓦级计算。每个兆瓦级的工厂的成本约为 6000 万美元,AI 工厂运营商只有在明确了解投资回报的情况下,才会决定投入如此规模的资金。影响 AI 工厂回报的关键因素有三个: 某方面的优势无法完全弥补另一方面的短板。如果工厂只能出售其产能的一部分,那么创收能力再强也意义有限。如果工厂仅运行一年后就无法满负荷生产,那么即便市场需求再旺盛也毫无意义。这三个因素并非相互独立。能够运行更多类型工作负载的工厂,会触达更多需求,从而年复一年地持续创收。 NVIDIA AI
AI 工厂的建设规模以兆瓦甚至达到十亿瓦级计算。每个兆瓦级的工厂的成本约为 6000 万美元,AI 工厂运营商只有在明确了解投资回报的情况下,才会决定投入如此规模的资金。影响 AI 工厂回报的关键因素有三个:
- 创收能力:如果工厂将其生成的每一个 Token 全部售出,一年内可以获得多少收入。
- 使用寿命:其 AI 硬件能够持续盈利的时间。
- 需求:对这些 Token 的需求量有多大。
某方面的优势无法完全弥补另一方面的短板。如果工厂只能出售其产能的一部分,那么创收能力再强也意义有限。如果工厂仅运行一年后就无法满负荷生产,那么即便市场需求再旺盛也毫无意义。这三个因素并非相互独立。能够运行更多类型工作负载的工厂,会触达更多需求,从而年复一年地持续创收。
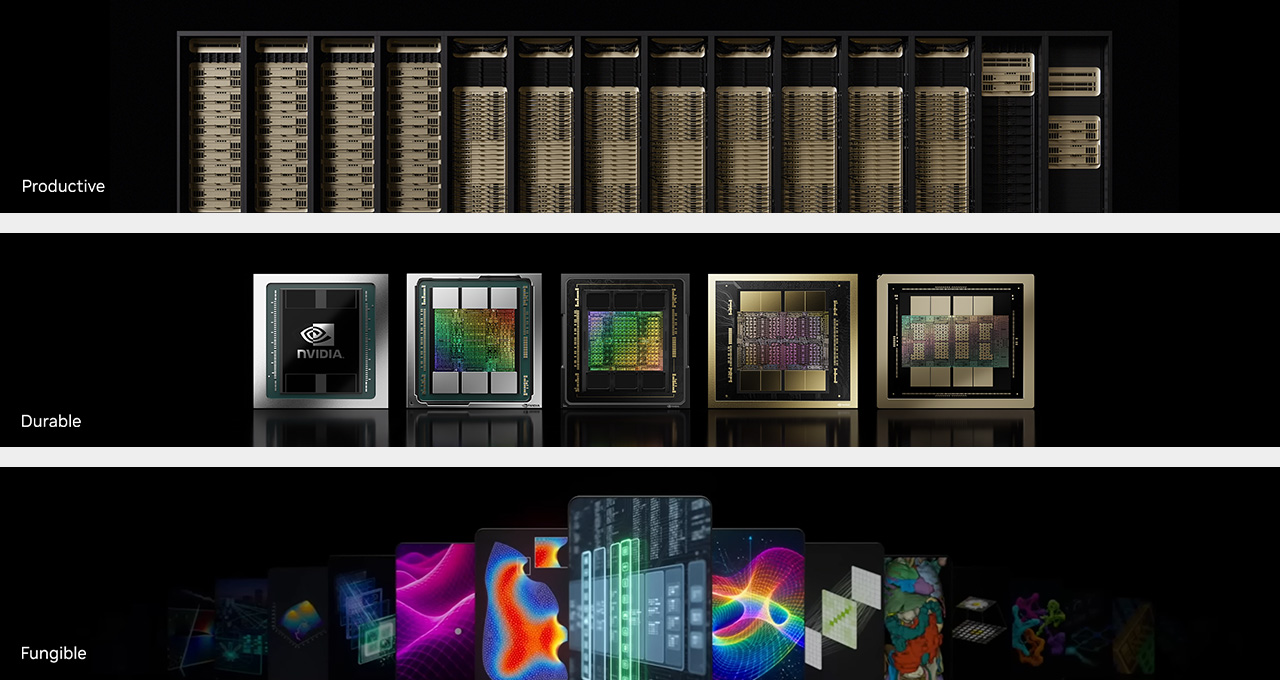
NVIDIA AI 工厂更大限度地提升这三个方面的表现,具体体现在:
- 高效:实现每兆瓦最高吞吐量和每 Token 最低成本,从而最大限度地提高创收能力。
- 耐用:NVIDIA GPU 和系统在出厂多年后仍然保持盈利,延长了使用寿命。
- 可互换性:能够运行各种类型的 AI,无论是在哪个阶段、哪个场景,以及许多根本不涉及 AI 的工作负载,从而满足更广泛、更深层的需求。
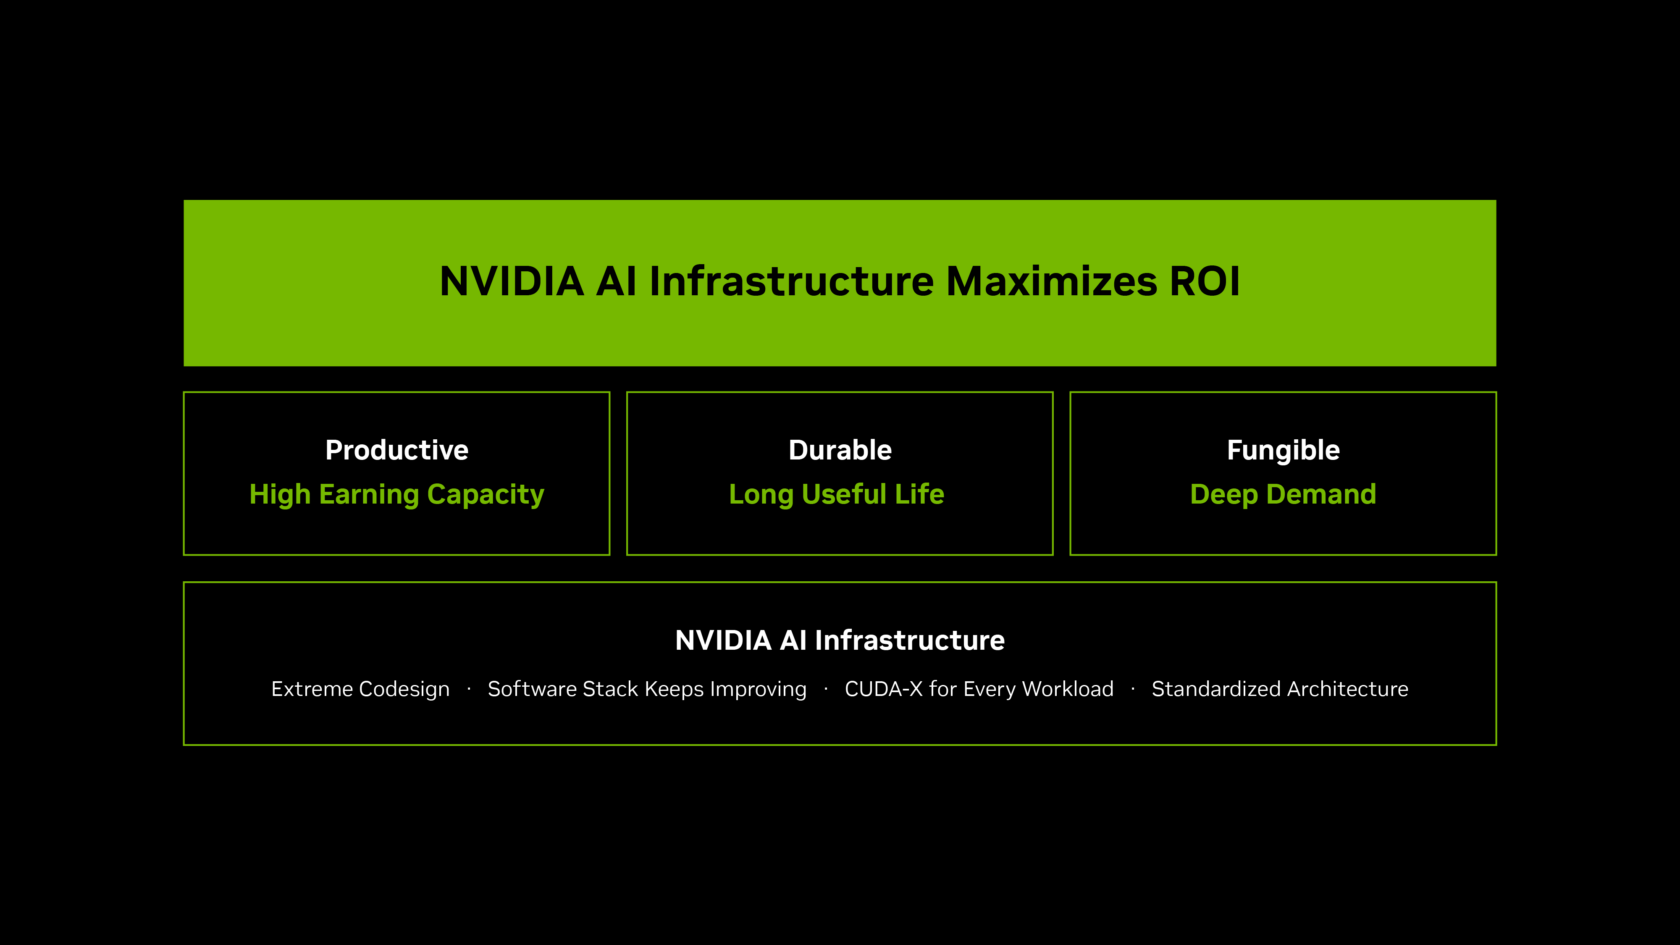
全栈工程协同设计可最大限度地提高 AI 工厂的吞吐量,而持续的软件优化可确保已部署的硬件在交付多年后仍能保持高效运行。NVIDIA CUDA-X 库使工厂能够运行各类加速计算工作负载。标准化架构则让任何运营商都可以基于经过验证的参考设计进行部署。
高效:每兆瓦 Token 产出最高,Token 成本最低
电力是 AI 工厂的关键制约因素。因此,每兆瓦每秒生成的 Token 数量决定了创收能力。固定功耗范围内的 Token 越多,收入就越多。每个 Token 的成本越低,利润空间就越大。
SemiAnalysis AgentX 数据显示,NVIDIA Vera Rubin 机架级系统的每兆瓦吞吐量比 NVIDIA Grace Blackwell 机架级系统高 30 倍以上;在 DeepSeek V4 Pro 模型上,每百万 Token 成本最多可降低至其 1/45。这种规模的收益来自全栈的极致协同设计:从模型和工作负载到软件、计算、网络和内存,所有环节都进行了优化。
因此引出了两个问题。如果每一代技术都大幅降低了 Token 的成本,那么算力需求是否会随之减少?
答案是否定的,需求会扩张。
Token 成本下降,使更多用例变得更划算,而这些用例消耗的 Token 比效率提升所节省下来的更多。
第二个问题是耐用性。如果每一代产品的性能都远超上一代产品,那么旧款产品会怎样?
耐用:已部署的产品持续创造收益
并非每个工作负载都需要最新的系统。适配与否取决于工作负载的复杂程度和特征。这解释了为什么上一代产品在新产品到来后仍然能继续创收。
CoreWeave 最近将 2020 年首次推出的设备的预订期限延长至 2029 年。多年来,各大运营商都延长了服务器的折旧计划,这是对硬件停止盈利时间的预估,而且这个时间还在不断推迟。2026 年 9 月 Sprout 发布的分析报告《数据中心 GPU 的创收寿命》梳理了各大运营商如何调整这个年限。
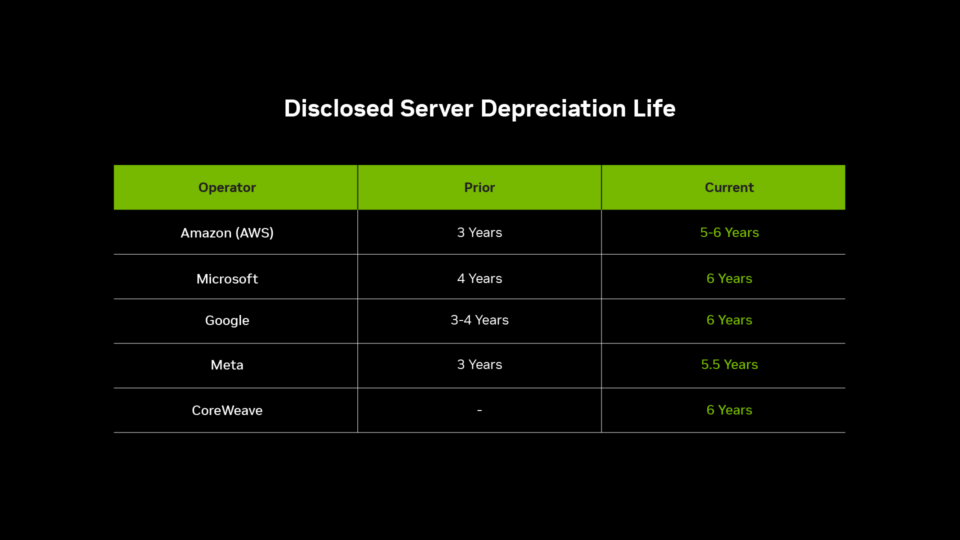
NVIDIA GPU 编程软件平台 CUDA 能够跨代运行,因此当新架构出现时,运营商已有的设备都不会被淘汰。持续的软件和内核优化,则在不断提升现有硬件的能力边界。
同一平台支持机器学习、深度学习、生成式 AI、推理、智能体 AI 和物理 AI。每一类新的工作出现时,都能在已部署的硬件上运行。
这就是可互换性。系统能够承担的工作种类越多,就能越长久地找到用武之地。
可互换:各种类型的 AI、各个阶段、各种场景
为单一工作而建的工厂,相当于押注这类需求会持续存在。而能够运行多种工作的工厂,即使工作发生变化,也能让其继续发挥作用并持续创收。
NVIDIA AI 工厂支持各种类型的 AI 模型,无论是开放模型还是专有模型,涵盖语言、视觉、生物学、物理学和机器人等领域。它们覆盖从数据处理到预训练、后训练和推理的每个阶段。也在各种场景中运行,从超大规模云和 AI 云到各个项目、企业数据中心和边缘端。
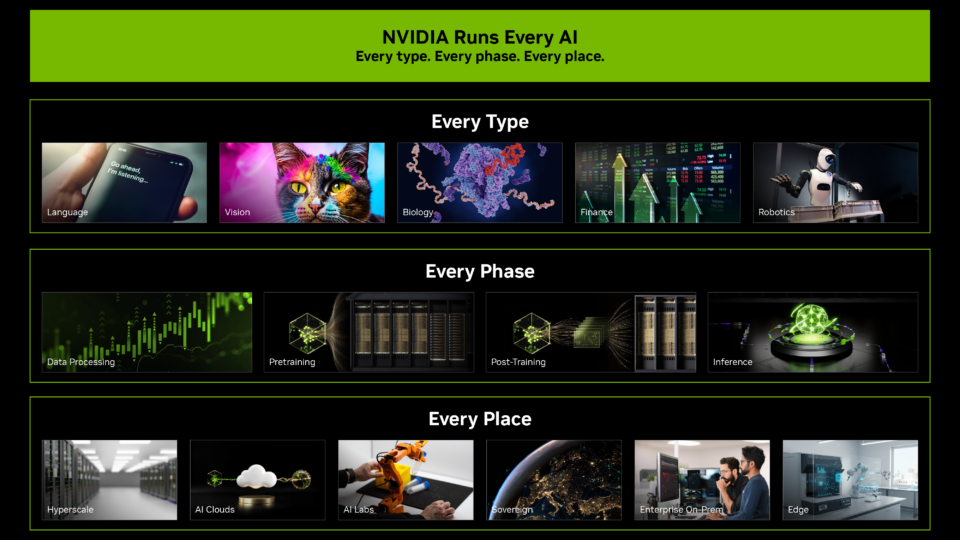
而这一切并不局限于构建和运行 AI 模型。同一基础设施还可运行数据处理、科学计算、仿真、图形等多种任务。
所有这些工作负载,无论是 AI 还是非 AI,都可归结为相同的并行计算。而 NVIDIA GPU 则专为此而设计,可同时在数千个核心上运行这些计算。CUDA 能让同一芯片既能模拟光线、模拟蛋白质折叠,也能预测下一个 Token。在此基础上,有超过 1000 个开箱即用的 CUDA-X 库和模型,涵盖了从深度神经网络、计算光刻和量子电路仿真到向量搜索和气候建模等各个领域,并已有超过 1000 万开发者正基于这些库和模型进行开发。
NVIDIA GPU 能支持通用加速计算,而非面向单一工作负载而构建的定制 ASIC。通用并不意味着泛化:Tensor Core 和 Transformer 引擎将 AI 优化的硬件置于可编程架构中,让同一芯片兼顾专业性和灵活性。以同一套架构承载所有这些工作负载,是保持高利用率和提高回报的关键。
这种通用性体现在不同客户的生产环境中:
- 礼来:在配备 1,016 块 GPU 的本地集群上构建并运行蛋白质、小分子和基因组学模型,同时为其团队提供聊天机器人和智能体工作流。
- Pinterest:在超大规模云上对视觉语言模型进行后训练与部署,所用规模达 14,000 块 GPU,横跨 NVIDIA Blackwell、Hopper 和早期架构。
- Revolut:使用 NVIDIA cuDF 处理数十亿条交易记录的数据,随后在 AI 云上训练和部署基础模型。
- Runway:依托云基础设施,在 NVIDIA Hopper 上训练世界模型,并在 NVIDIA Blackwell 平台上提供推理服务。
- 德克萨斯 A&M 大学:在超级计算机上运行分子模拟和 AI 药物研发,在 26 个项目和 7 家机构中,利用率达到 95% 至 98%。
AI 领域之外也是如此。Cosm 运营由 NVIDIA 提供支持的分布式数据中心,为高分辨率视频播放、流媒体传输、实时图形和同步显示提供灵活的计算资源。达索系统为威奇托州立大学的飞机认证和 Lucid Motors 的车辆设计提供虚拟孪生仿真支持。联合利华则通过数字孪生生成产品图像,取代了实体拍摄,将制作成本削减了一半。
这样的案例无法一一列尽,而这恰恰就是重点所在。
NVIDIA AI 工厂的设计目标是高效、耐用和可互换:让 Token 带来更高的利润、更长的使用寿命并满足更深层的需求。这就是实现回报最大化的关键。
如需进一步了解 NVIDIA AI 工厂,请关注 NVIDIA 创始人兼首席执行官黄仁勋将于北京时间 10 月 21 日 (星期三) 17:00 在 GTC 柏林的主题演讲。