Vera 尽显双重优势:兼具最高吞吐量与最快智能体性能
AI 智能体不只是生成答案。它们还会搜索信息、查询数据库、编写并测试代码,以及采取行动。 这些步骤中的每一步都依赖 CPU,在整个任务过程中,智能体会在 GPU 推理与 CPU 执行之间反复切换。 随着企业部署更多智能体,AI 工厂需要能够快速执行这些步骤、支持大量智能体同时运行的 CPU,且这一切都要在可用电力的限制内完成。 这意味着什么:AI 基础设施提供商需要支持更多的智能体,同时又不能让每个智能体为了完成任务而等待更长的时间。更关键的是,AI 工厂正面临严重的电力瓶颈。这就要求运营商在选
AI 智能体不只是生成答案。它们还会搜索信息、查询数据库、编写并测试代码,以及采取行动。
这些步骤中的每一步都依赖 CPU,在整个任务过程中,智能体会在 GPU 推理与 CPU 执行之间反复切换。
随着企业部署更多智能体,AI 工厂需要能够快速执行这些步骤、支持大量智能体同时运行的 CPU,且这一切都要在可用电力的限制内完成。
这意味着什么:AI 基础设施提供商需要支持更多的智能体,同时又不能让每个智能体为了完成任务而等待更长的时间。更关键的是,AI 工厂正面临严重的电力瓶颈。这就要求运营商在选择基础设施时,必须确保每一瓦特的电力都能发挥出最大的算力价值。
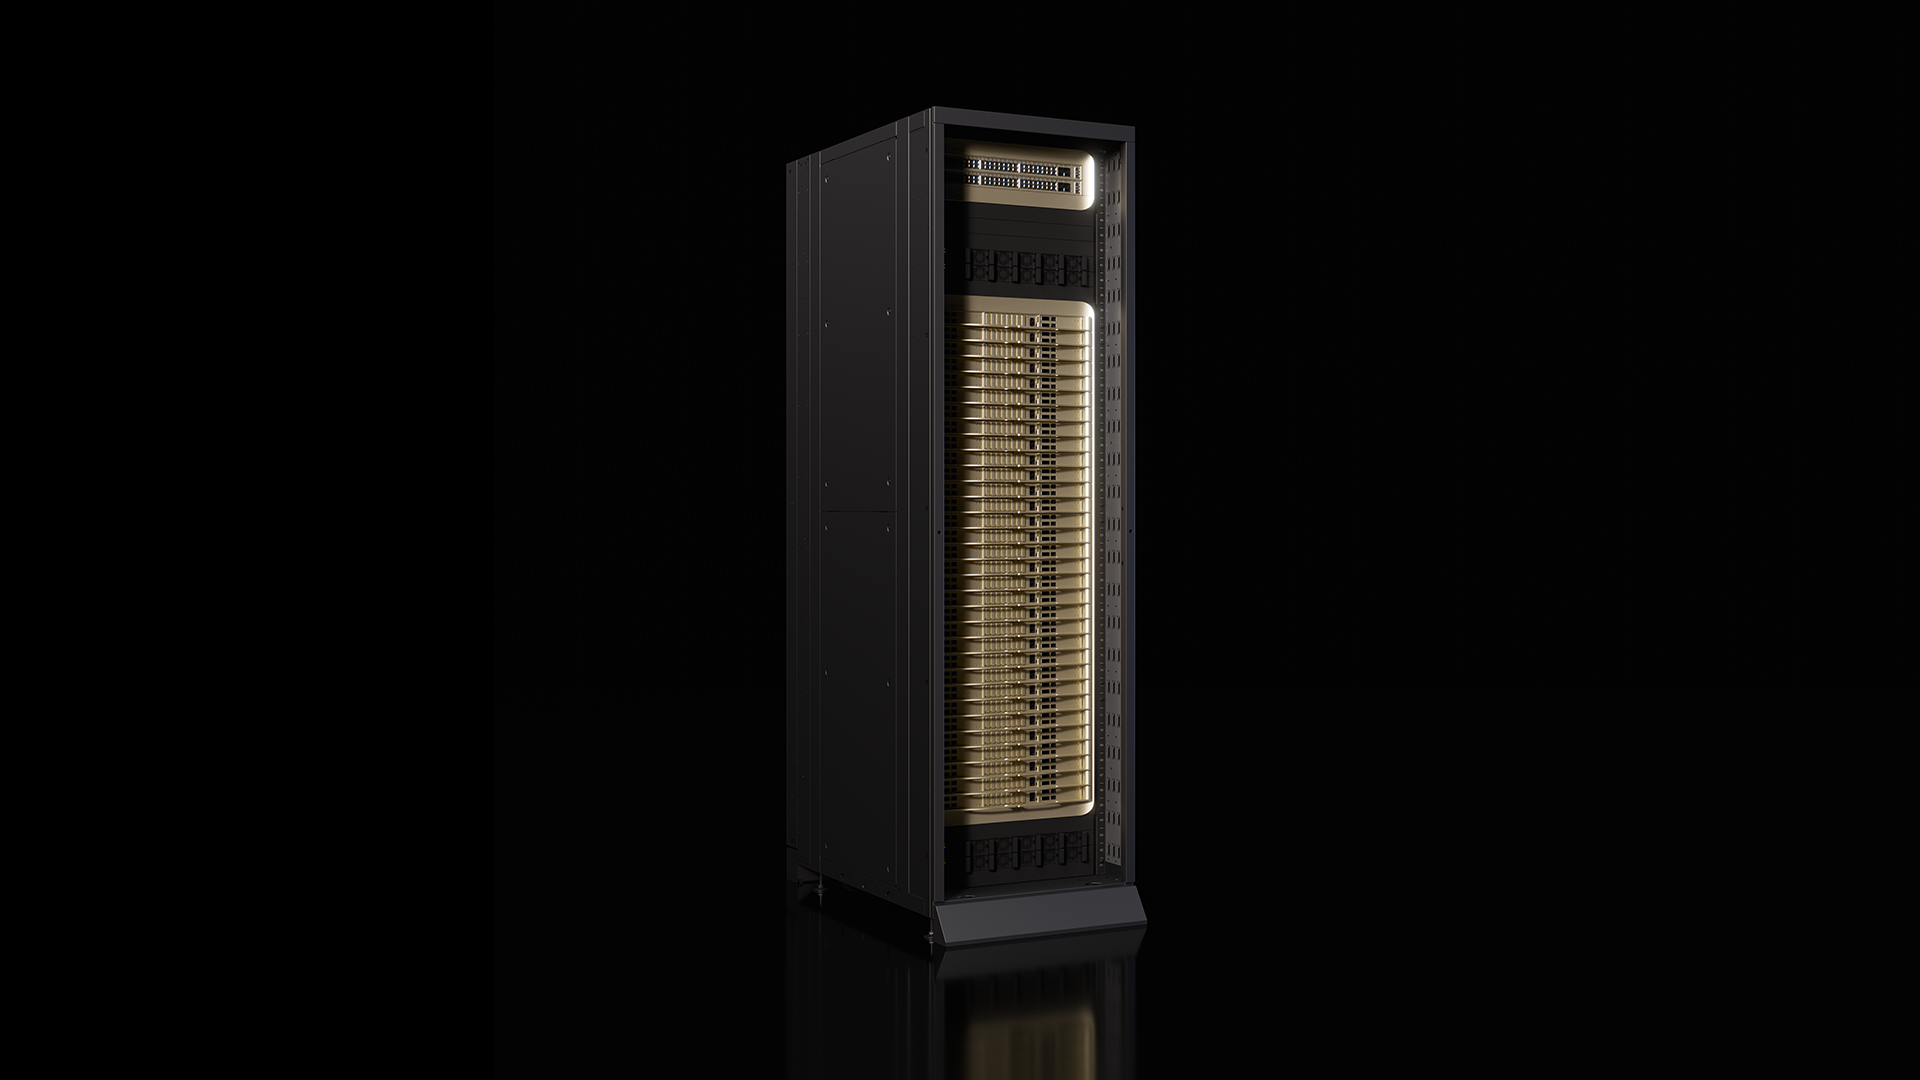
为什么重要:NVIDIA Vera 在单一 CPU 内兼顾了极快的智能体性能与极高的每瓦性能容量。这意味着运营商只需一款 CPU 就能应对各种智能体工作负载,而无需像过去那样,为了平衡速度与容量,去拼凑搭配不同的 x86 处理器。
数据佐证:在一项 100 兆瓦数据中心的对比测试中,NVIDIA 发现,单颗 Vera CPU 的表现超越了当前速度最快的 x86 CPU 以及能效最高的 x86 CPU。
- Vera 具备业界领先的智能体执行速度;同时,与速度最快的 x86 CPU 相比,Vera 在同等功耗下可支持多 1.6 倍的智能体。
- 与能效最高的 x86 CPU 相比,Vera 的智能体执行速度提升了 2 倍,且依然保持着领先的能效表现。
各大合作伙伴已经开始将 Vera 投入实际应用。在早期的采用者中,他们在模拟真实生产环境的测试里,同样见证了其卓越的性能表现:
- Perplexity:使用 Vera 运行智能体编码任务的速度,比传统 CPU 快了 1.5 倍。Perplexity 计划在其即将推出的生产系统中正式部署 Vera。
- DeepInfra:在其生产级智能体工作负载中,Vera 在智能体编排任务上的速度达到了最佳 x86 处理器的 2.2 倍,在参与测试的四种架构中表现最快。
- ClickHouse:其标准二进制文件无需针对 Vera 进行专门调优,即可在 176 个核心上实现接近线性的性能扩展,并登顶 ClickBench 硬件性能排行榜。
- DuckLabs:相比英特尔至强 6 基准平台,其中位 TPC-H SF1000 性能提升了约 1.5 倍。
- Daytona:使用 Vera 仅需 10.8 秒即可启动 1,000 个智能体沙箱;在 2,000 个并发沙箱的负载下,每秒可完成 12.7 个任务。相比之下,x86 平台完成同等启动需要 88.4 秒。
- Modal:与同类 x86 硬件相比,Vera 实现了高达 2 倍的每核心沙箱吞吐量,且在高负载下性能优势更加显著。
了解更多关于 NVIDIA Vera CPU 的信息。
Jat AI
Stay informed with the latest in artificial intelligence. Jat AI News Portal is your go-to source for AI trends, breakthroughs, and industry analysis. Connect with the community of technologists and business professionals shaping the future.